Blog Tecnològic

Blog everyWAN

Tecnologia, ciberseguretat i tendències IT que importen

Anàlisi Profunda
Ciberseguretat
Tendències IT
Filtrar per:
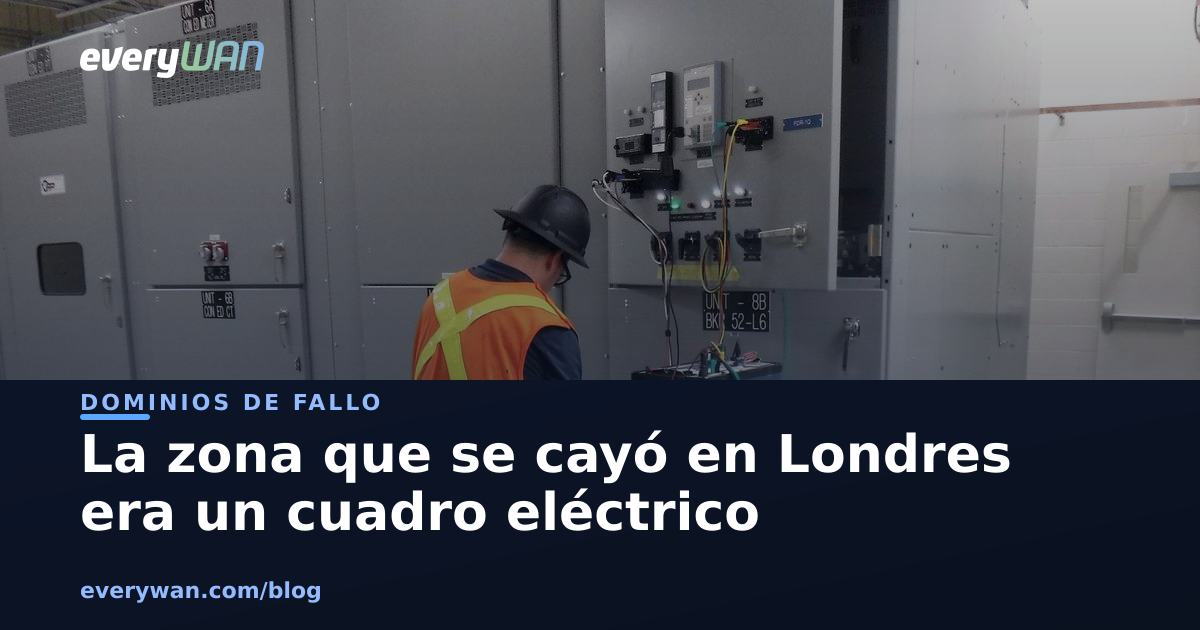
Sala de cuadros eléctricos de una instalación real: una hilera de armarios de maniobra grises con un técnico midiendo en un interruptor
8 min lectura

La zona que va caure a Londres era un quadre elèctric

El 20 d'octubre del 2026, a les 06:08 UTC, un «esdeveniment elèctric» dins d'una sola zona —europe-west2-b, una de les tres de la regió de Londres de Google Cloud— va deixar sense servei bancs, paqueteria i portals durant gairebé vuit hores. No va caure una regió: va caure el corrent dins d'una zona. I «estem repartits en dues zones» no és una resposta, perquè el nom d'una zona és una etiqueta de repartiment, no un lloc que puguis auditar: AWS documenta que us-east-1a no és el mateix lloc físic en dos comptes diferents. Expliquem per què el domini de fallada que més costa és el que ningú no dibuixa, per què la jerarquia per defecte de Ceph fa anys que té un tipus de cub anomenat pdu, quan NO convé pujar el domini de fallada i el plànol d'una fila per rèplica que omplim a peu d'armari.
Bahías de disco de una cabina montada en rack, con unidades etiquetadas y varios huecos vacíos
6 min lectura

L'últim pedaç de Ceph Squid no és al teu repositori de Proxmox

El 12 d'octubre de 2026 Ceph va publicar la 19.2.7, setè backport de la branca Squid, amb la frase de sempre: «recomanem que tots els desplegaments actualitzin». Avui hem mirat què serveix de debò el repositori de Proxmox i la resposta és 19.2.6-pve4, amb l'índex datat el 9 de setembre. La branca mor el 31 d'octubre. Dos calendaris diferents, i el que et governa no és el que llegeixes a ceph.io.

Parte trasera de un armario de servidores con los latiguillos de red saliendo de cada nodo hacia los de al lado
10 min lectura

La malla de Ceph sense switch té quatre variants. Dues es trenquen amb un cable

Tres nodes connectats entre si a 25 GbE sense comprar cap switch és de les millors decisions que es poden prendre amb pocs diners. Proxmox documenta quatre maneres de cablejar-ho i només dues sobreviuen a la caiguda d'un enllaç: a les altres dues, diu la seva pròpia wiki, «els nodes tenen visions diferents» i Ceph marca com a caiguts serveis que estan perfectament vius. Des de Proxmox VE 9 aquesta malla es configura des de la interfície, amb quatre protocols de fabric. I la documentació oficial continua etiquetant aquesta capa com a tech preview.

Bastidor de paneles de parcheo de fibra óptica con mazos de latiguillos naranjas
9 min lectura

43 CVE al switch de fibra de la teva cabina, i cap no és crítica

El 8 d'octubre del 2026 el NVD va publicar 43 vulnerabilitats de Brocade Fabric OS el mateix dia. Cap de crítica, la més alta 8,7, i 38 de les 43 exigeixen credencials. Aquests tres números són exactament el motiu pel qual ningú no ho pedaçarà. A dins: l'atacant que el lot imagina no ve d'internet —és un altre switch de la teva pròpia fabric—, per què el 7,1 de CVE-2026-87659 enganya, l'excusa de la finestra de manteniment desmuntada amb la documentació del mateix fabricant, les dues branques de versió que no encaixen, i quatre preguntes de propietat en comptes d'un checklist.

Filas de bahías de disco SAS en servidores de almacenamiento montados en rack
13 min lectura

Vas posar noout per actualitzar Ceph i vas apagar la reposició de còpies

El procediment d'actualització de Ceph a Proxmox et recomana, al seu pas quatre, que executis «ceph osd set noout»: «optional, but recommended», diu el wiki. La documentació de Ceph, a la seva pàgina de resolució de problemes d'OSD, diu que això és «més un exercici mental» que un suggeriment que ningú «al món post-Luminous» ho executi. Les dues frases estan publicades avui i totes dues són defensables. El que aquesta bandera apaga no és el rebalanceig: és que un OSD «down» arribi a «out», que és just el pas que fa que CRUSH recalculi i es creï la còpia que falta. I la bandera no distingeix entre el disc que vas reiniciar tu i el que s'ha mort de debò. A dins: per què mon_osd_down_out_subtree_limit ja et frena l'escenari que de debò fa por, la cadena que gairebé ningú explica (els PG degradats no es marquen com a clean, i el que no és clean no es scrubeja: deixa de verificar-se el checksum just de les dades a les quals els falta una còpia), l'aritmètica dels dos avisos que arriben als 10,5 i als 12,25 dies a un tauler que fa amarell des del minut u, la taula del que cada bandera apaga de debò, i les quatre ordres que fan la mateixa feina sobre un disc o sobre un host sense tocar la resta del clúster.

Bahías de disco de un servidor con bandejas medio extraídas y huecos vacíos
8 min lectura

La teva redundància suposa que el recanvi arriba demà

Un disc es mor un dimarts i no passa res: per això vas pagar la rèplica. Però el que vas comprar no és immunitat, és una finestra de temps per reposar abans de la següent avaria, i aquella finestra es va calcular donant per fet que el recanvi arriba demà. Western Digital va dir a la seva crida de resultats que estava «pràcticament venut per a l'any natural 2026» i Seagate que la seva capacitat nearline estava «completament assignada» per al mateix període, amb acords de núvol que ja arriben al 2027 i al 2028. Fem l'aritmètica amb les taxes de fallada publicades per Backblaze: amb el recanvi en 48 hores, la probabilitat d'una segona fallada abans de la reparació és del 0,18 %; amb el recanvi en 20 setmanes, de l'11,5 %. El mateix disseny, els mateixos discos, 66 vegades més risc per una variable que no surt en cap diagrama. On fa més mal (el node, no el disc), la retallada de retenció que no signa ningú, i les sis preguntes que fem ara abans de donar per bo un disseny.

Nodos idénticos apilados en un rack, cada uno con su pantalla y su etiqueta
9 min lectura

El teu Ceph de tres nodes no es cura sol: aguanta

Un disc mort en un clúster de tres nodes s'arregla sol si queda un altre disc en aquell mateix servidor: la regla de CRUSH baixa a un altre OSD del mateix host. Un HOST mort, no. Amb rèplica 3 i el domini de fallada en «host» —el que hi posa Proxmox per defecte— no existeix un quart lloc on deixar la tercera còpia, així que els grups de col·locació es queden en active+undersized+degraded fins que torni el node. I el clúster continua servint, que és justament per això que ningú no se'l mira. Els temporitzadors reals de Ceph (20 segons, 10 minuts, 15 minuts), el que no pots tocar mentre duri la finestra degradada, per què la recuperació et pot costar el quòrum de corosync i per què el número que importa no és quants nodes tens sinó quants llocs diferents.

Cabina de disco montada en rack, con dos filas de bandejas de disco y sus pilotos de actividad
10 min lectura

Migrar a Proxmox i reaprofitar la cabina: l'snapshot és el que no viatja

La cabina està pagada, així que es queda: és la decisió més barata del projecte i la que més canvia el teu dia a dia. A Proxmox l'snapshot no el fa l'hipervisor, el fa el plugin d'emmagatzematge, i sobre un LUN compartit amb LVM-thick la documentació diu «snapshots are not possible by default…». El que ho arregla porta des de la 9.0 etiquetat com a technology preview, i el fabricant ho posa per escrit al seu full de ruta. Les set opcions reals i l'arbre de decisió que signem.

Varios servidores de 1U apilados en un rack, con cableado de red blanco recogido y pantallas LCD de estado en el frontal
13 min lectura

Ceph canvia de xifratge: reiniciar la màquina virtual no refresca la clau

El 9 de setembre Proxmox va publicar el procediment per migrar les claus cephx d'aes a aes256k. La part difícil no és criptogràfica: és saber què compta com a «refrescar un client». La documentació ho diu en sis paraules —«A guest reboot is not enough»— i la fallada no apareix quan executes l'ordre, sinó minuts o dies després, quan caduca un tiquet. Què ha canviat des d'agost, la porta del kernel 7.0 i l'ordre que seguim nosaltres.

Filas de bandejas de disco SAS en el frontal de varios servidores de almacenamiento montados en rack
9 min lectura

Squid va guanyar 42 dies i Tentacle en va perdre 170: el fi de suport de Ceph el va moure un commit

El 5 d'agost, un commit a la documentació de Ceph va moure les dues dates que ordenen el calendari de qualsevol amb emmagatzematge distribuït en producció: Squid va passar del 19 de setembre al 31 d'octubre, i Tentacle del 18 de novembre de 2027 a l'1 de juny de 2027. La pròrroga es veu al gràfic; la retallada de 170 dies a la versió de destinació no l'hem vista comentada enlloc. Què significa que el camp es digui target_eol i per què Tentacle viu 560 dies on Squid en va viure 765.

Actualizar Ceph de Squid a Tentacle en Proxmox: la ventana en la que el clúster corre en dos versiones
9 min lectura

Ceph a Tentacle: durant l'actualització el teu clúster corre en dues versions alhora

Squid caduca el 31 d'octubre i Tentacle fa des del juliol que és al repositori empresarial de Proxmox, així que la finestra de manteniment ja no és hipotètica. A dins hi passa una cosa que gairebé cap pla no contempla: monitors, gestors i OSD es reinicien per separat, i el clúster passa hores —o dies— partit en dues versions. Per què «reinicia els OSD d'un node cada vegada» decideix la teva finestra, per què dir «opcional» a noout és enganyós, i l'ordre amb la qual gairebé tothom es dona per acabat abans d'hora.

Servidores de rack idénticos apilados en un carro metálico, pendientes de montar, delante de un rack a medio poblar
5 min lectura

Corosync suma 650 mil·lisegons per cada node: el rellotge que el teu clúster actualitzat continua arrossegant

El temps que triga un clúster Proxmox a refer la membresia després de perdre un node no és fix: creix 650 ms per cada node que hi afegeixes, i amb els valors de fàbrica un clúster de 29 nodes arriba a 45,21 segons, just on la mateixa documentació demana corregir-ho abans que el watchdog de 60 segons reiniciï nodes sans. Proxmox VE 9.2 el va baixar a 125 ms, però només en crear el clúster: els actualitzats de la 8 a la 9 continuen amb el valor vell.

Servidor de almacenamiento abierto en un rack con las bahías de discos a la vista y una unidad extraída de su carro
9 min lectura

A Ceph la capacitat no la marca el clúster: la marca el disc més ple

Un OSD per damunt del 95 % atura les escriptures de tot el clúster encara que «ceph df» continuï ensenyant desenes de teres lliures. Els tres llindars per defecte (0,85 / 0,90 / 0,95), per què el mecanisme que repara s'apaga cinc punts abans que el que serveix, i el compte de capacitat amb un node menys que gairebé ningú no fa: amb quatre nodes el sostre són 71 punts, i 67 si vols que la reconstrucció arribi a acabar.

Chasis de servidor de almacenamiento extraído sobre sus guías en un pasillo de datacenter, con dos filas de discos de 3,5 pulgadas en bandejas metálicas y un destornillador apoyado en el borde
7 min lectura

Ceph pedaça quatre CVE: tres els tanca el paquet i el quart el tanques tu

El 19 d'agost Ceph va publicar Squid 19.2.6 i Tentacle 20.2.4 amb l'etiqueta [URGENT]. Una de les quatre fallades no s'arregla instal·lant: obliga a rotar totes les claus CephX del clúster, deu passos a mà, i deixa el clúster en HEALTH_ERR mentrestant. Què hi ha dins de cada CVE, per què qualsevol amb una clau «mon allow r» podia llegir les passphrases LUKS dels teus discos, i què vam trobar avui en mirar el repositori de Ceph de Proxmox.

Un parquímetro con el indicador EXPIRED en rojo y un coche todavía aparcado detrás: la fecha ha pasado y no ha cambiado nada visible
9 min lectura

Proxmox VE 8 caduca a l'agost: Debian et continuarà pedaçant, l'hipervisor no

La taula oficial de Proxmox diu 2026-08 i no diu el dia. El que sol quedar fora del titular és que el suport estès de Debian 12 arriba fins al juny del 2028 per la via de sempre, així que apt continuarà instal·lant pedaços reals en un node sense suport. Què es congela exactament, com comprovar-ho, l'ordre de l'actualització a la 9.2 i per què forçar-la a l'agost pot ser pitjor que arribar tard.

Interior de un disco duro abierto: el rendimiento real de un OSD de Ceph no lo marca la ficha del fabricante sino el benchmark que midió el propio OSD
7 min lectura

Ceph no rendeix el que diu la fitxa del disc: rendeix el que va mesurar l'OSD en arrencar

Des de Ceph Quincy el planificador dels OSD BlueStore és mClock, i el sostre de feina que reparteix no surt de la fitxa del fabricant: surt d'un benchmark que cada OSD executa en arrencar. Si aquesta mesura es descarta, queden 315 IOPS per a un disc mecànic i 21.500 per a un d'estat sòlid, compris el que compris. Com comprovar què es creu el teu clúster, quins paràmetres van deixar de fer efecte i quan el disc sí que és el problema.

Parte trasera de un rack de nodos de almacenamiento: la mejora de Fast EC se enciende pool por pool, no con la actualización
7 min lectura

Fast EC arriba apagat: l'interruptor de Ceph Tentacle que només gira un cop

Ceph Tentacle porta Fast EC, la feina de rendiment en erasure coding que feia anys que s'esperava. I arriba apagat: s'encén pool per pool, amb una ordre, i el monitor es nega a apagar-lo després —revertir-ho és buidar i recrear el pool—. A més, el «com a mínim el doble» del titular es va mesurar amb un stripe unit de 16K, que és exactament el que un pool ja creat no pot tenir. Les condicions que comprova el monitor, la meitat de la millora que va quedar congelada el dia que vas crear el pool, què li passa al clúster en encendre'l i per què la rèplica de tres vies continua sent més ràpida.

Ceph Squid 19.2 llega a su fin de vida estimado el 19 de septiembre de 2026
7 min lectura

El teu Ceph té data: Squid es queda sense pedaços el 19 de setembre

La taula de cicle de vida de Ceph situa el final de vida estimat de Squid (19.2) el 19 de setembre del 2026: cinquanta dies des d'avui. La substituta, Tentacle (20.2), és estable des del novembre i a Proxmox està marcada com a estable des de la 9.2. El problema no és el salt, és que no és un salt: és una seqüència de tres finestres l'ordre de les quals no tries tu, amb dos detalls que gairebé ningú no ha mirat — el mòdul mgr/zabbix desapareix i les optimitzacions d'erasure coding no s'activen soles.

Proxmox VE 8 llega a su fin de soporte en agosto de 2026
5 min lectura

Proxmox VE 8 es queda sense pedaços a l'agost: per què no actualitzarem el dia 30

La taula de cicle de vida de la documentació oficial de Proxmox situa el final de vida de la branca 8 a l'agost del 2026. Queden poc més de trenta dies i la reacció típica és bloquejar un cap de setmana i saltar a la 9. La nostra postura és la contrària: hi ha sis situacions en què actualitzar aquest agost és pitjor idea que arribar tard. L'asimetria de la migració en viu que converteix la teva tornada enrere en una restauració, per què Ceph són dues finestres i no una, els contenidors amb systemd vell que no arrencaran, i el repartiment realista dels trenta dies que queden.

  • 1
  • 2

Subscriu-te al nostre butlletí

Per rebre històries del món IT, novetats d'everyWAN i ofertes exclusives per a subscriptors, dona't d'alta a la nostra llista de correu

everyWAN
everyWAN